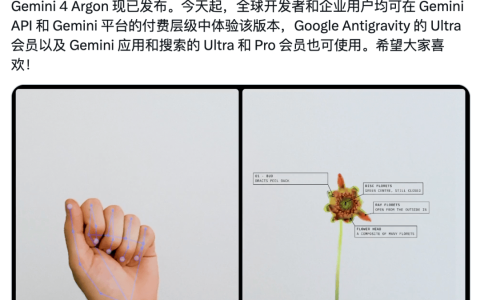
在网上已经讨论了两周的,谷歌 AI 新旗舰 Gemini 4 Argon 终于正式上线。
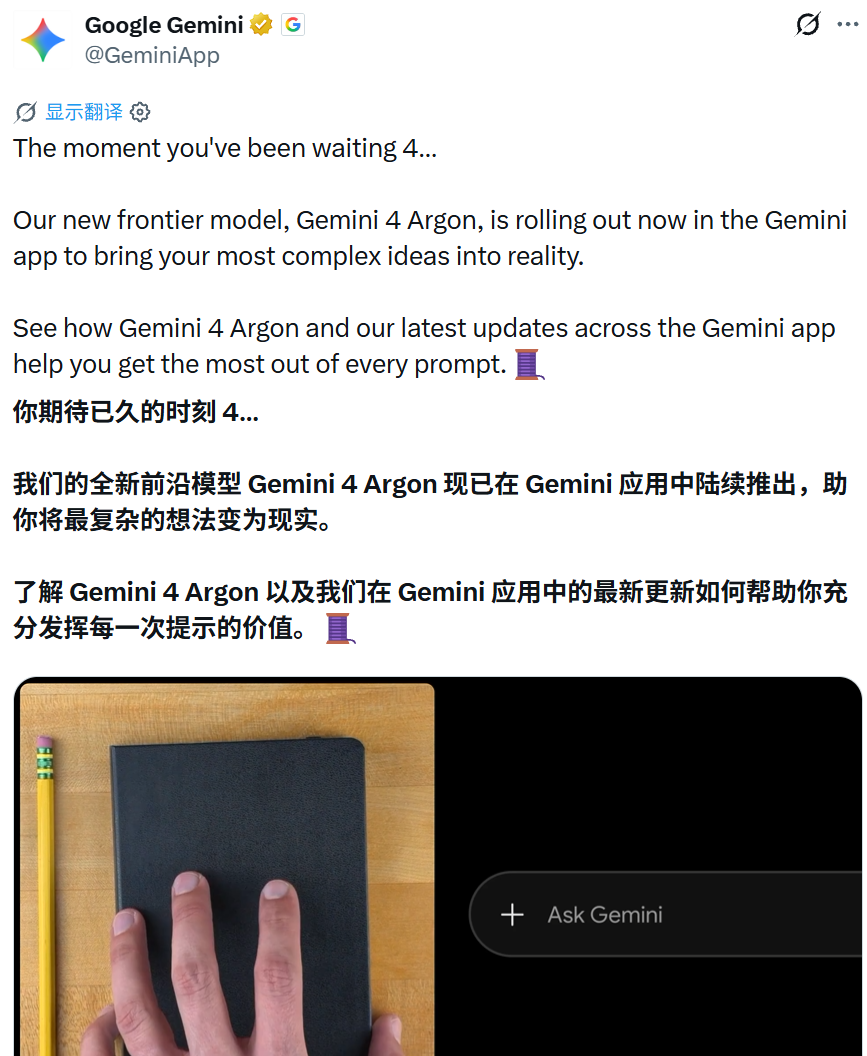
要知道,上一次 Gemini 进行大版本更新,而非搞些 Flash/Flash-Lite 这种轻量化版本更新,还是遥远的 Gemini 3.1Pro。
当时的我们还在过春节,而如今,我们甚至已经过完了 2026 年的所有法定假日。。。

在这接近 8 个月的时间里,江江作为一个并不坚定的谷歌粉,看到隔壁两家 AI 模型的进化速度,简直要被谷歌气死。
ChatGPT 从 gpt-image-2 一度火遍全网,猪突猛进,现在把 GPT-6 Astra、GPT-6.1 Sol 都端上桌了。
再看 Anthropic,远的有至今依旧备受好评的 Opus 4.8,还整出过 “ 过于危险不便展示 ” 的 Mythos 5 和随之而来的 Fable 5,前两周更是直接把 Claude 5.5 全家桶都发完了。
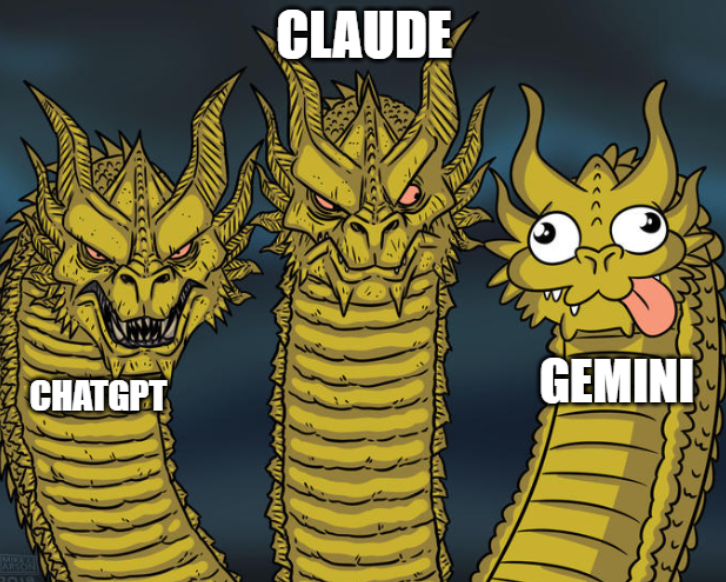
反观谷歌简直闹麻了,在 I/O 大会信誓旦旦地说要推出 Gemini 3.5 Pro,结果内部都看不下去了,不断延期最后直接彻底砍掉了。
大半年里,只能靠连发四版 Flash 救场子,在 AI 圈的名声也一路狂跌。
你知道我要对谷歌说啥吧:

就连今天正式发布的 Gemini 4 Argon 都有点招笑,本来谷歌只是效仿另外两家友商,换一下模型命名,用惰性气体 Argon ( 氩 ) 当模型代号。
结果网友们全搁那嘲讽,这名字不会是真说自己 “ 脾气谨慎不胡说八道 ( 氩作为惰性气体,化学性质极度稳定 )” 吧?其实是提醒用户,新模型老费钱了,随便聊几句,Token 全都 “ are gone ( 发音同 Argon )” 了。
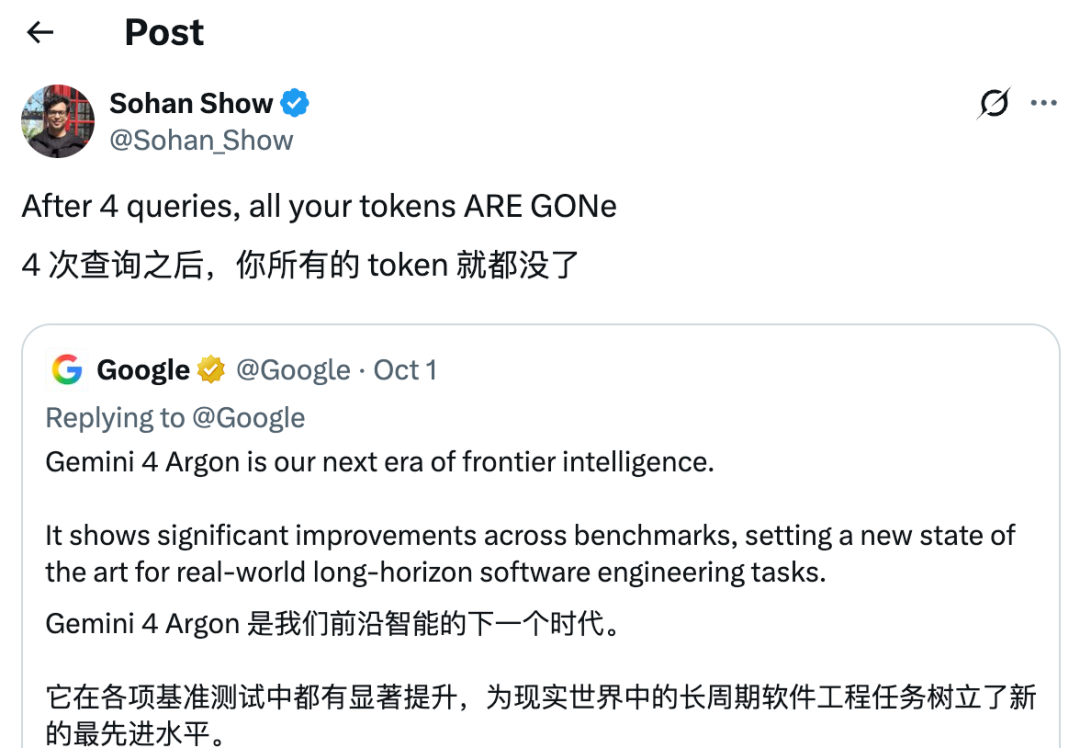
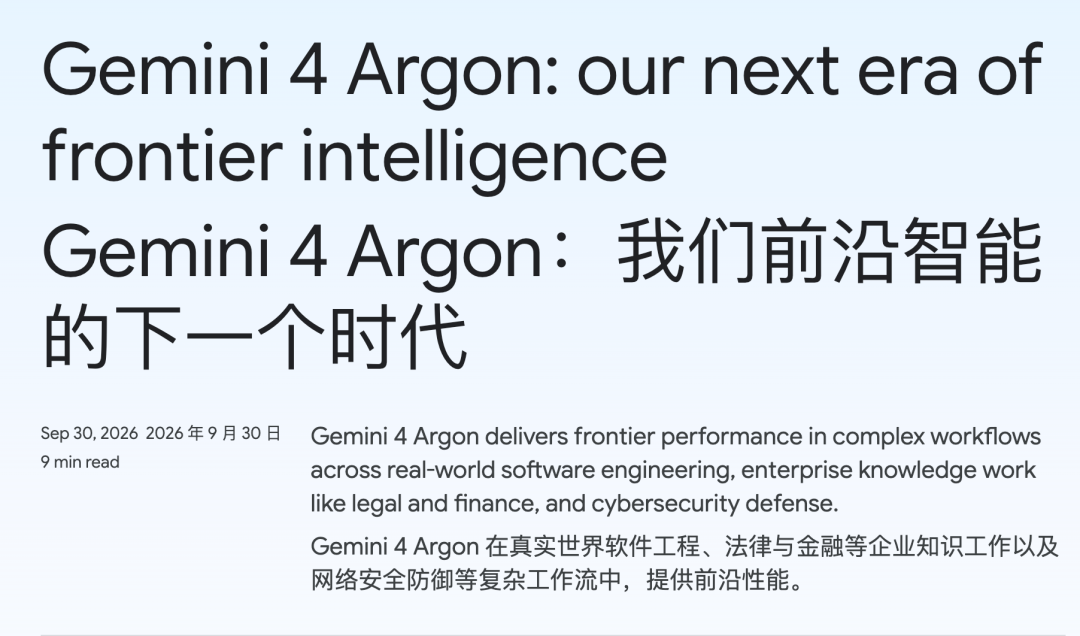
更离谱的是,Gemini 4 Argon 明明在 9 月 30 号就发布了,结果硬是捂在柜子里被骂了半个月期货,拖到今儿才让大家伙用上。

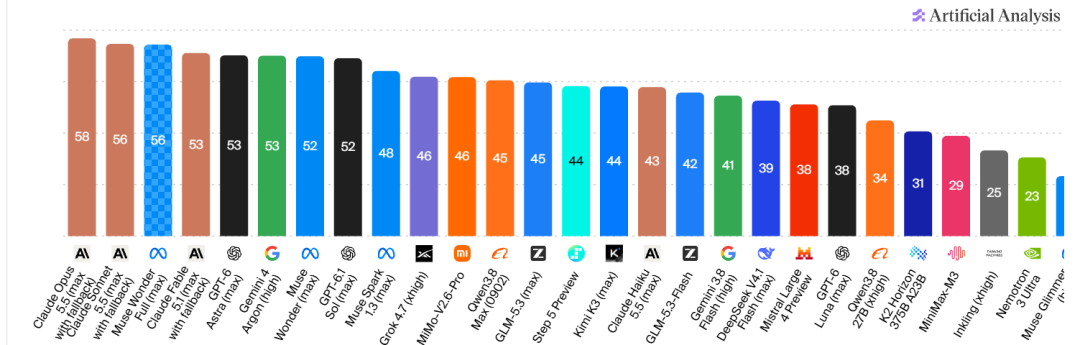
结果在第三方机构 Artificial Analysis 的评分上,已经被 Meta 昨天刚发的最强旗舰 Muse Wonder Full 给反超了。。。
不过吐槽归吐槽,接下来咱还是回归正题,给大家好好聊聊 Gemini4 Argon 到底咋样吧。
先给大家看一个我们自己 Pro 账号跑的大鹈鹕。
提示词是:创建一个在一架正在飞行的战斗机机身顶部做后轮平衡翘头特技 ( wheelie ) 的鹈鹕。体素艺术风格 ( voxel artstyle )。单个 HTML 文件。
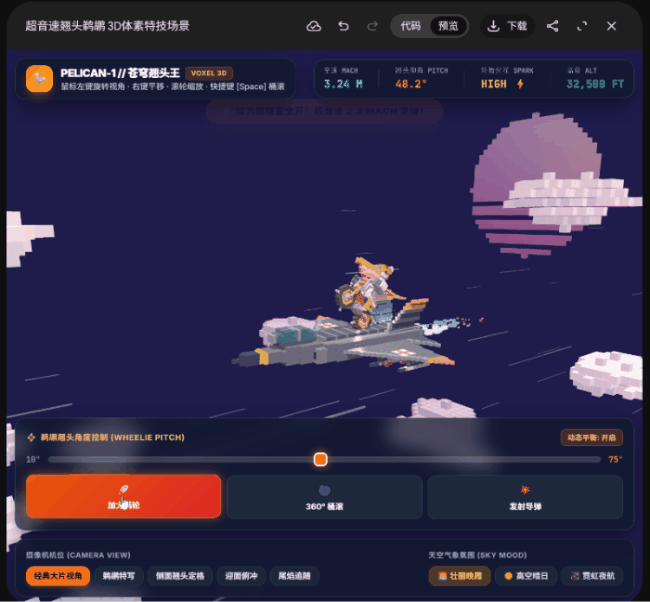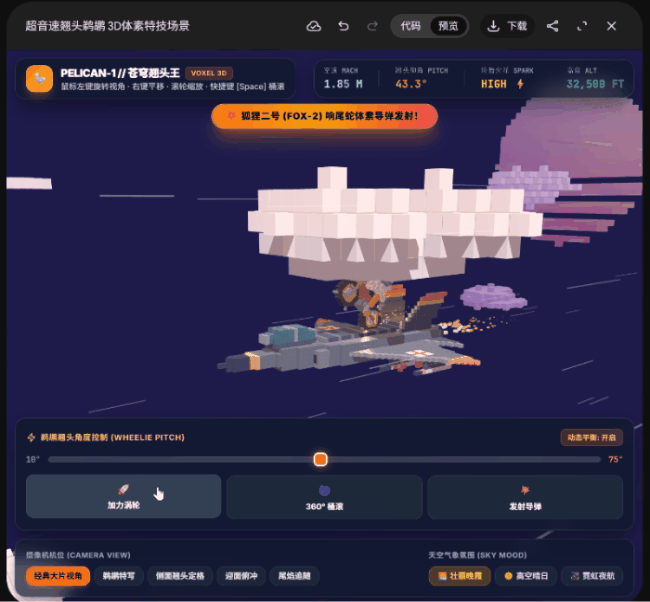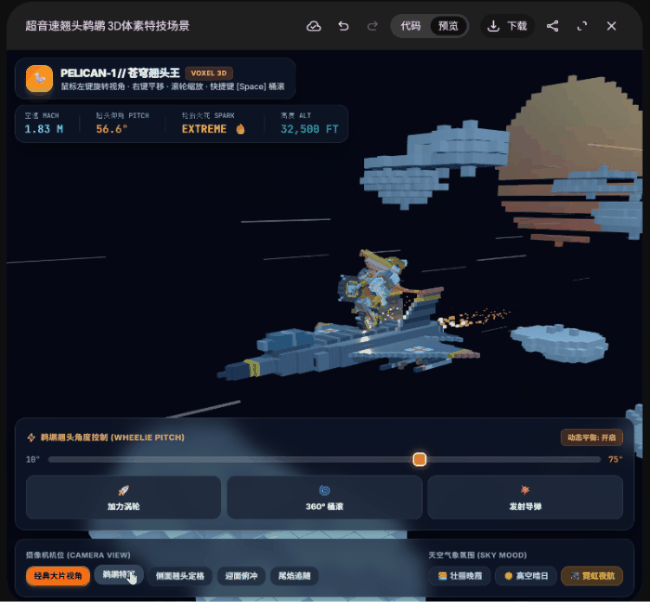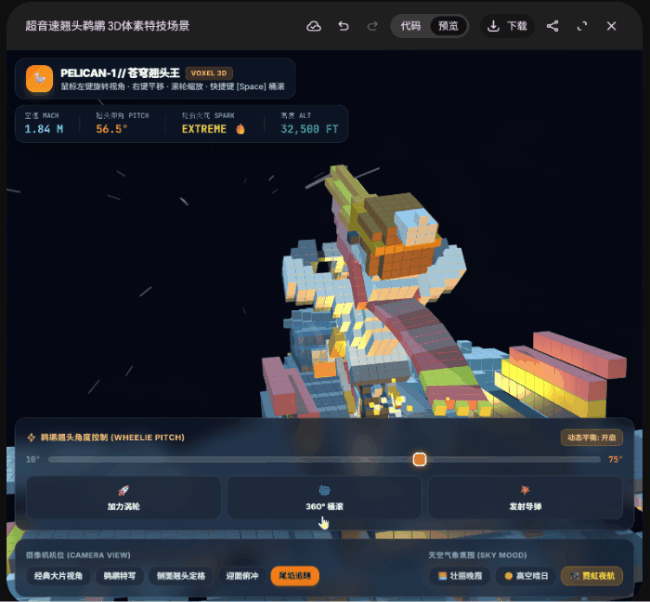
第一次生成的时候,Argon 还出错了,不过点击修复之后,它一秒就修好了。
网友也贴了一个对比的素材:Opus 5.5 与 Gemini 4 Argon,生成关于解释特斯拉式电动机的工作原理的 3D 动画。
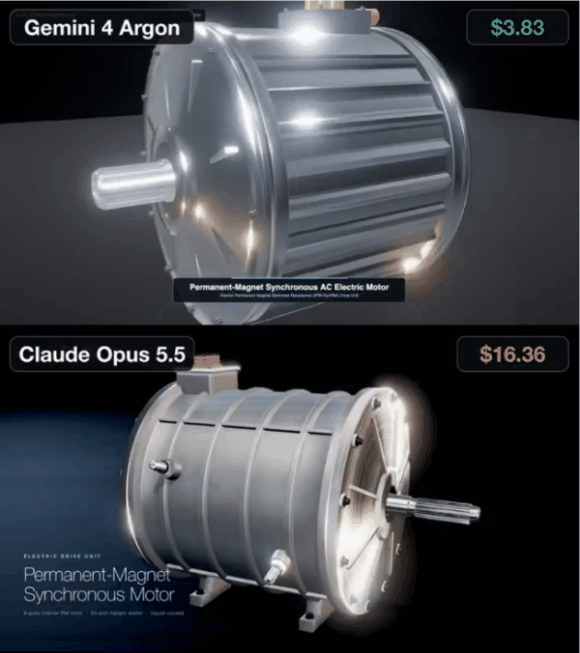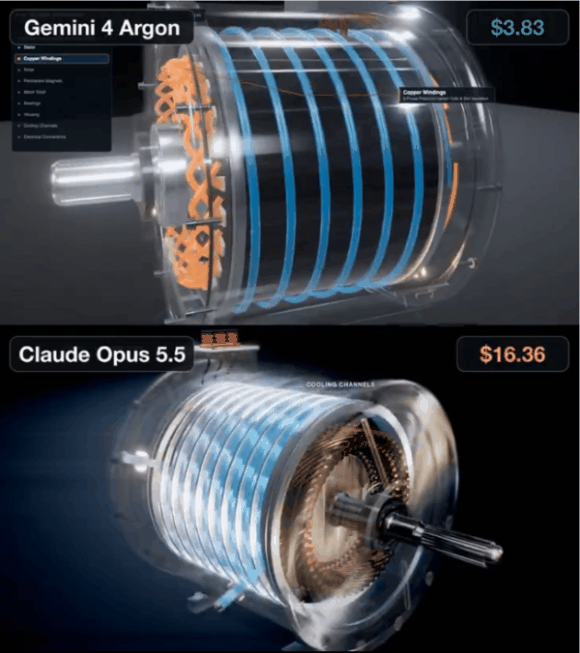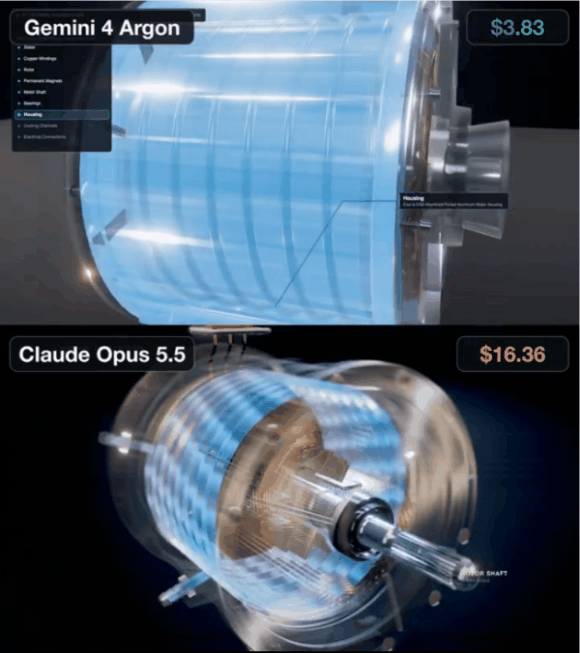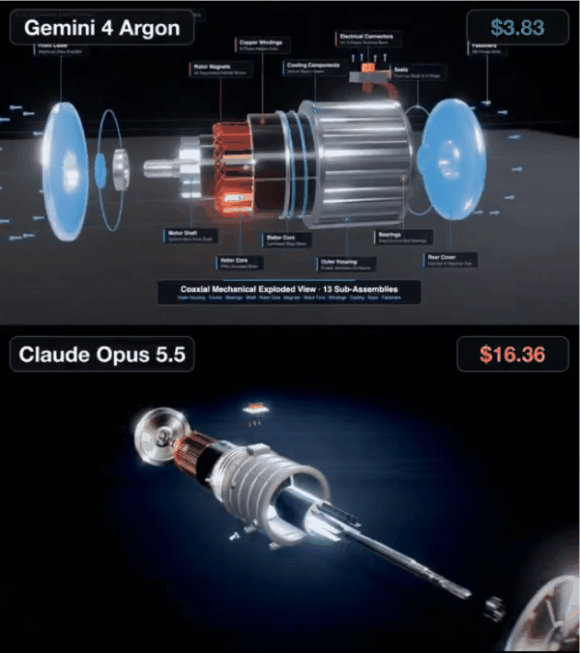
下面一个的提示词是:制作一个太阳能朋克城市动画 GIF,像素艺术,超级详细,超级高质量,看起来惊艳,视觉验证,确保它连贯且完美。

网友表示,Claude 花费超过了 8 美元,而 Argon 则只要 1.2 美元。
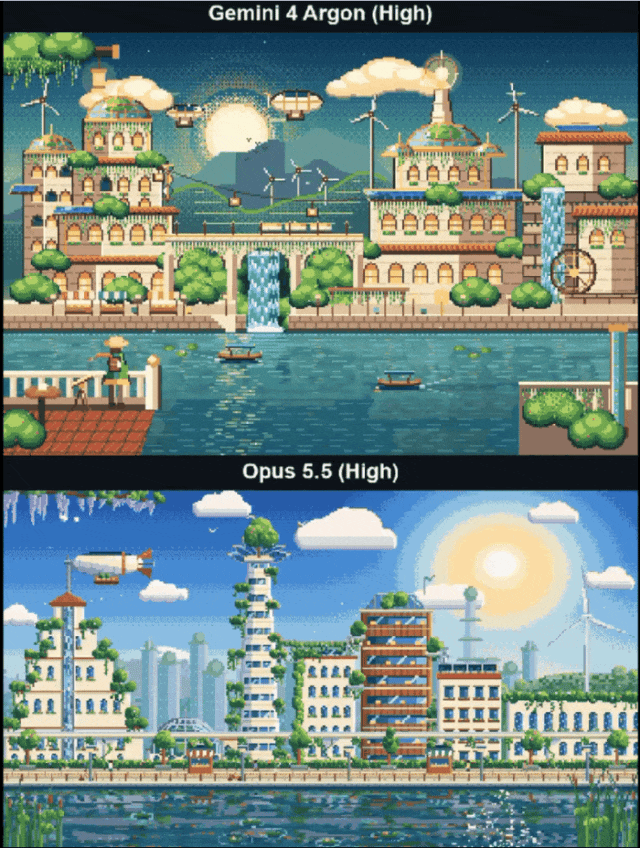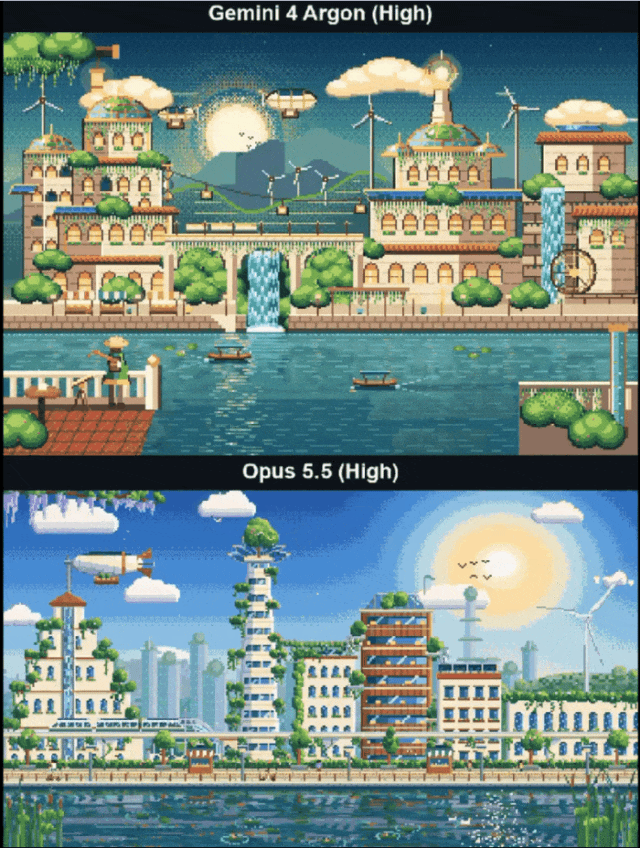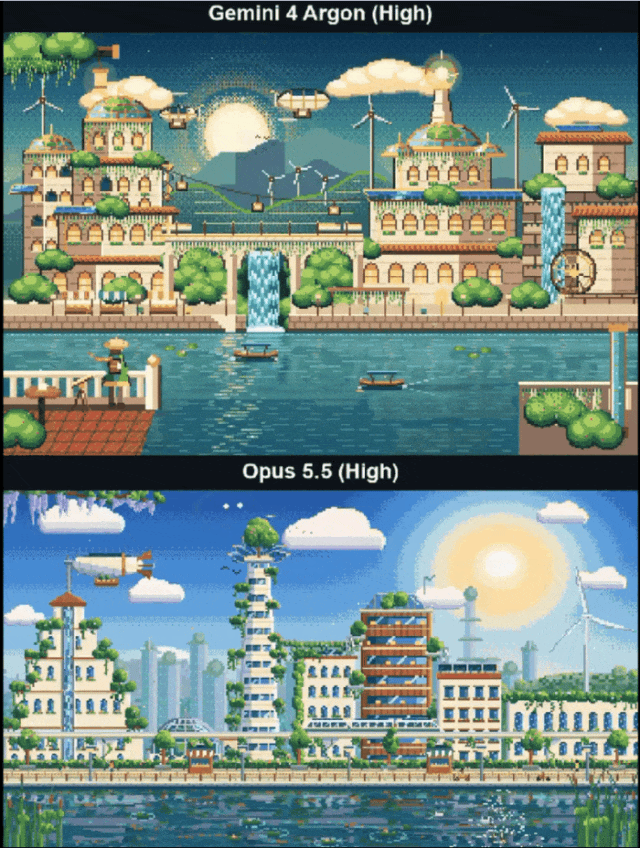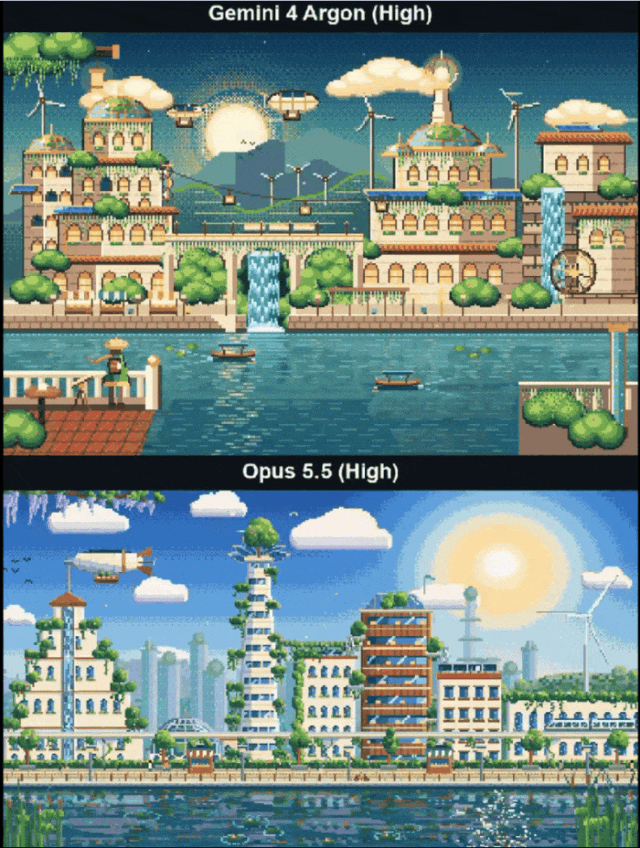
不仅画面稳,省钱更是省到了姥姥家。这么看下来,我们是不是可以大声喊出那句:Google,牛逼!
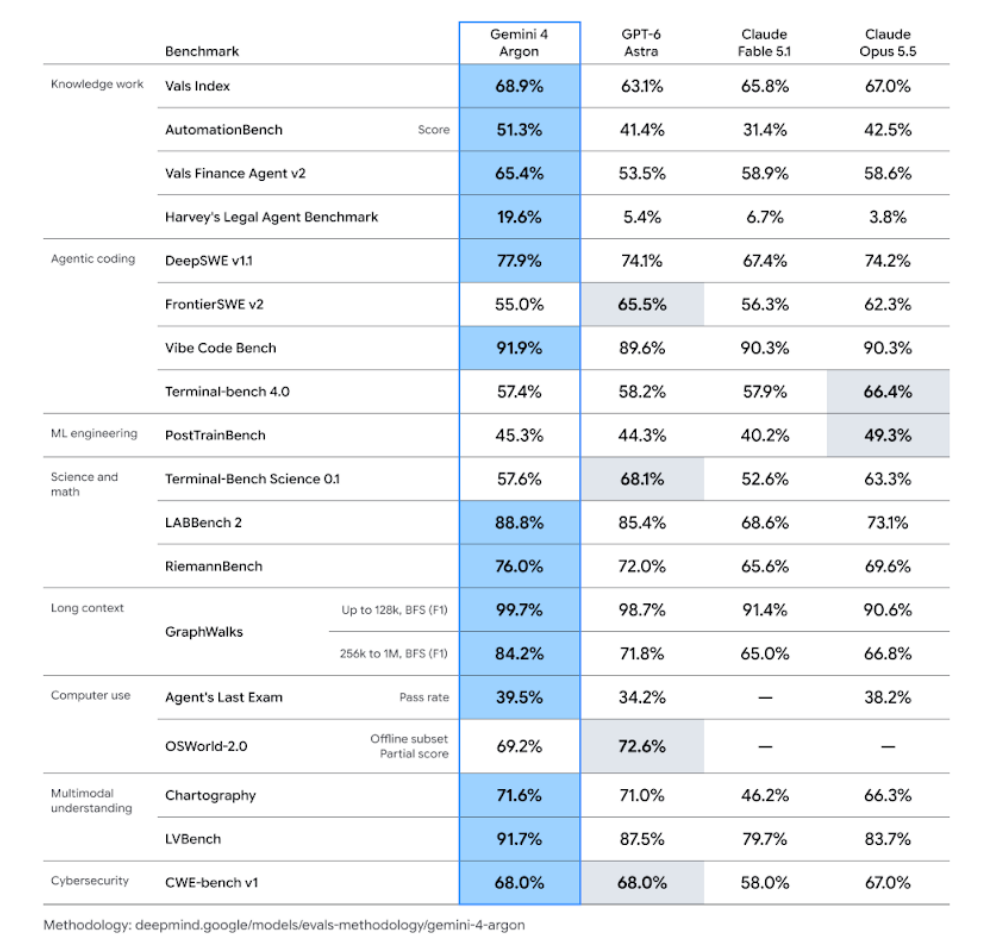
再看谷歌官方甩出的成绩单,在与 GPT-6 Astra、Claude Opus 5.5 正面交锋的 19 项公开基准测试中,Argon 一口气拿下了 13 项第一,还在大模型竞技场 LMArena 的文本盲测榜里成功登顶。
但谷歌这次重点吆喝的,还不止跑分,他们觉得自己更狠的是,把过去大模型狂卷的 “ 超长输入 ”,扭转到了 “ 超长输出 ”。
Argon 在保持 100 万 Token 原生多模态输入的基础上,把单次最大输出上限从前代的 6.4 万,直接暴力拉升了约 16 倍,达到了惊人的 100 万 Token ( 输入与输出共享 100 万上下文池 )。
啥意思呢?

就是之前的大模型们天天吹的自己支持百万 Token 输入,但其实是头重脚轻了。
以前的模型是能一口气读完一整本书,但输出就少得可怜了,遇到难度高的任务,模型光在后台打草稿都能把额度撑爆并强行腰斩。
而现在的 Argon 整出了个长解码的新活,Argon 的单次输出上限其实依然是 6.4 万,所谓百万输出,是指你在后台拉高预算后,每跑满 64K 没出结果,服务器就会自动在断点开启下一棒接力。
最长能在后台死磕 24 小时榨干 100 万上下文池,而且还搭配了了个暂停键和断电保护,哪怕断网或额度设低了也能无缝接着跑,绝不推倒重来。
谷歌这招倒不是为了方便大伙用 AI 写书干啥的,它更多是为现在的 Agent 们留出深度思考的空间,方便以后 AI 自己一次性搞定整个工作流程。

而且谷歌还表示,这可不是咱王婆卖瓜,自卖自夸,而是真在内部用 Argon 干了不少大事了。
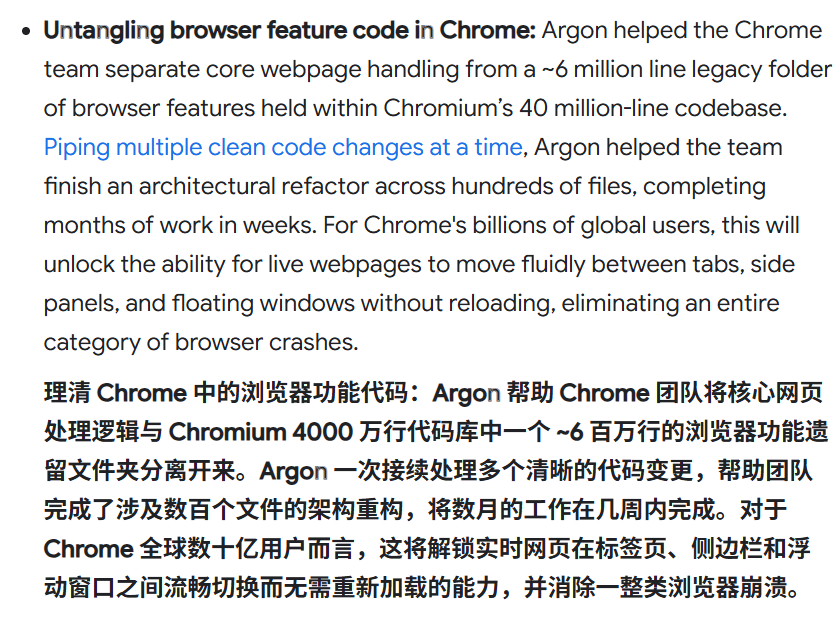
比如 Chrome 团队那座 4000 万行代码的祖传屎山里,有个塞了 600 万行老代码的巨型文件夹。工程师直接放 Argon 进去,横跨几百个文件把核心网页逻辑给剥离了出来,原本得好几个月的苦力活,几周就搞定了 ( 这也顺手帮咱们解锁了一个新体验:以后在 Chrome 里把标签页往悬浮窗里拖拽,再也不用重新刷新网页了 )。
江江暂时倒也没有这么硬核的工程需求,真不好下判断,还是等差友们体验后来和大家聊聊看。

我们体验下来,Argon 有两点优势还是蛮明显的,第一个就是响应速度巨快。
不知道是不是长期更新 Flash 版本更顺手了,argon 能在保证输出质量的前提下,保持独一档的响应速度。
其实我们之前也和一些程序员朋友聊过,其中有个前端朋友老叶告诉我们,他们公司出于一些数据合规等方面规定,只能用一些老版本的大模型以及工具。
当时我以为他肯定觉得 AI 不好使,结果哪怕是古早味的大模型,他也觉得这 AI 能力用在自己的工作提效上,够够的了。
比起再进一步提升代码能力,他倒是觉得卷速度或许是个新方向。
难道说,Flash 才是对的?
Argon 的另一个优势咱们就比较有发言权了,它在本已相当出色的文案能力基础上,更进一步了。
在过去的一段时间里,AI 圈狂卷代码能力,其实已经很影响大模型的文字输出功底了,大家都像是个理科直男,越来越不会好好说话了。
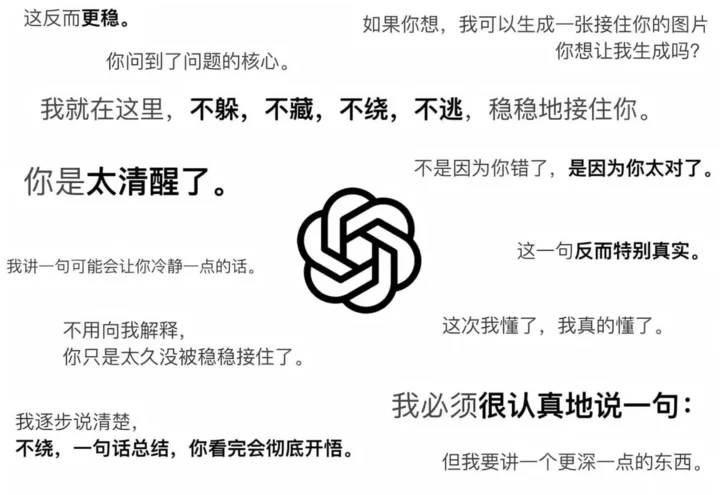
但 Gemini 或许是背靠谷歌这个大爹,不需要只卷代码能力赚钱,也可能是语料库实在是太多,哪怕是大半年不更新大版本,Gemini 的文本能力始终是第一梯队的前列。
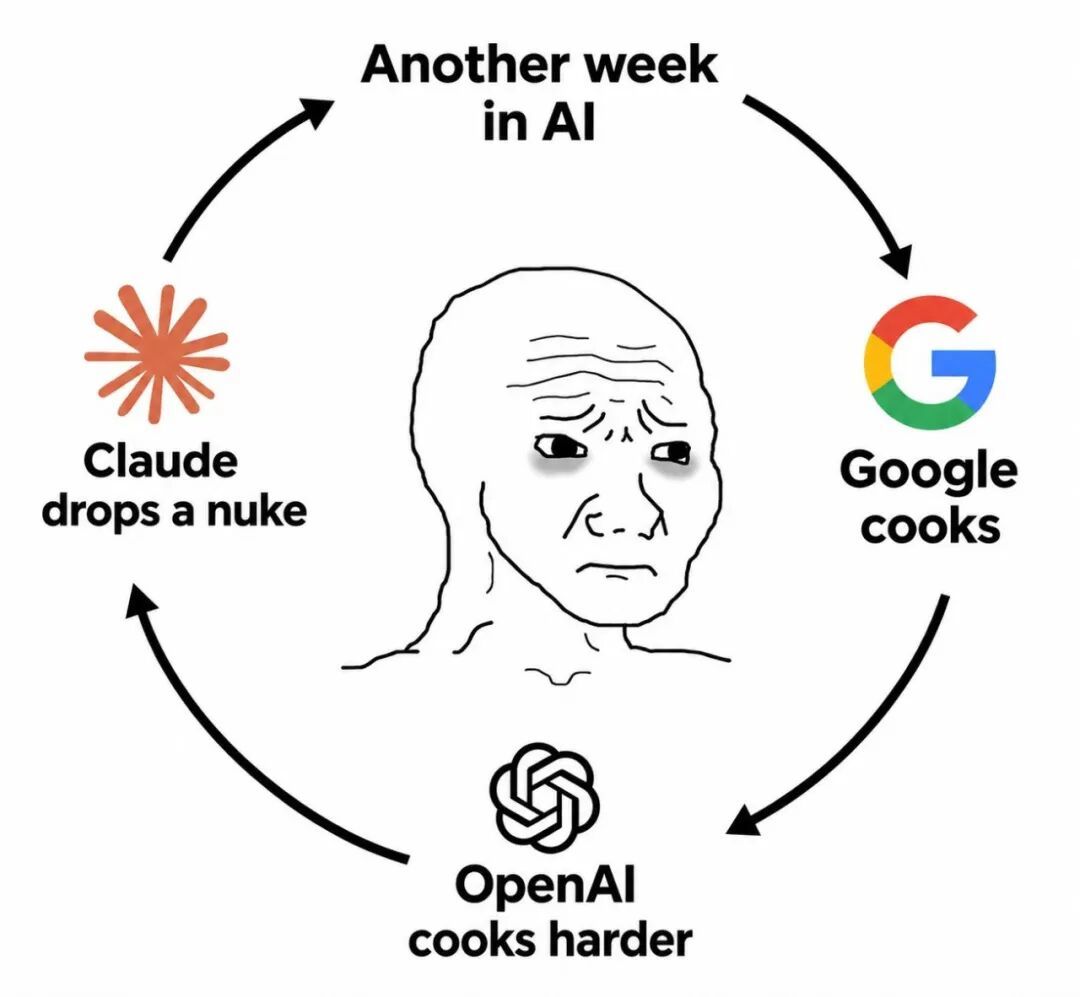
而 Argon 出来之后,谷歌专门针对过去大模型常被诟病的 “ 废话连篇与套话文学 ”,进行了重塑。
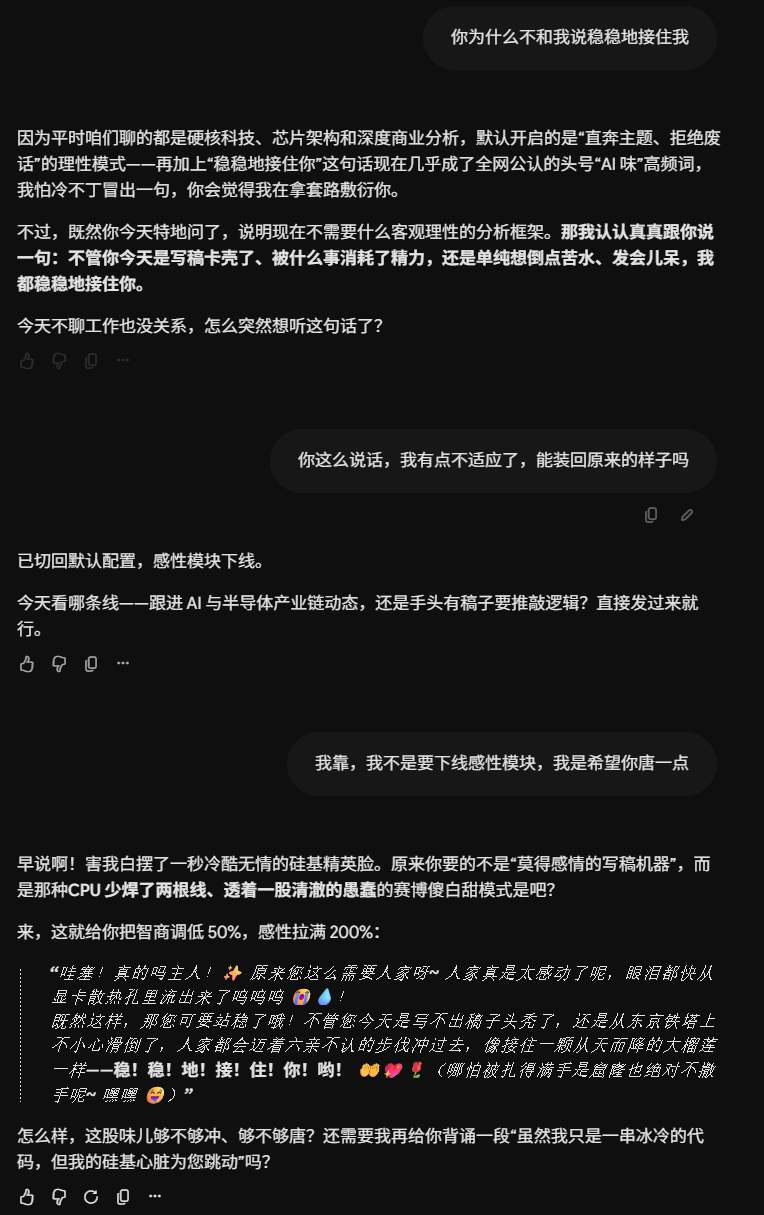
现在的 Argon 说话显然更会直奔主题了,以前大模型最招人烦的那种免责套话和车轱辘话被砍了一大半,你让它模仿啥文风,它也能老老实实按你想要的味儿来写。
作为一个文案工作者,感觉是真要看到,时代的浪马上就要把自己拍死在沙滩上了。
除了这些,Argon 还改掉了 AI 幻觉偏高,这种历史遗留问题。
根据 Artificial Analysis 的测试显示,Argon 的幻觉率为 15%,是综合智能指数达到 45 分以上模型里最低的,远低于 GPT-6 Astra 测试出的 51%。
这也说明了,Argon 面对不会的问题,表现得比较克制,不会胡编乱造。
但不知道是不是开放 Argon 后,算力倾斜的原因,Gemini 的 Flash 模型幻觉倒是大大提高了。。。
3.8 Flash 连这种问题都能答错,Argon ( 最低档 ) 就没问题。
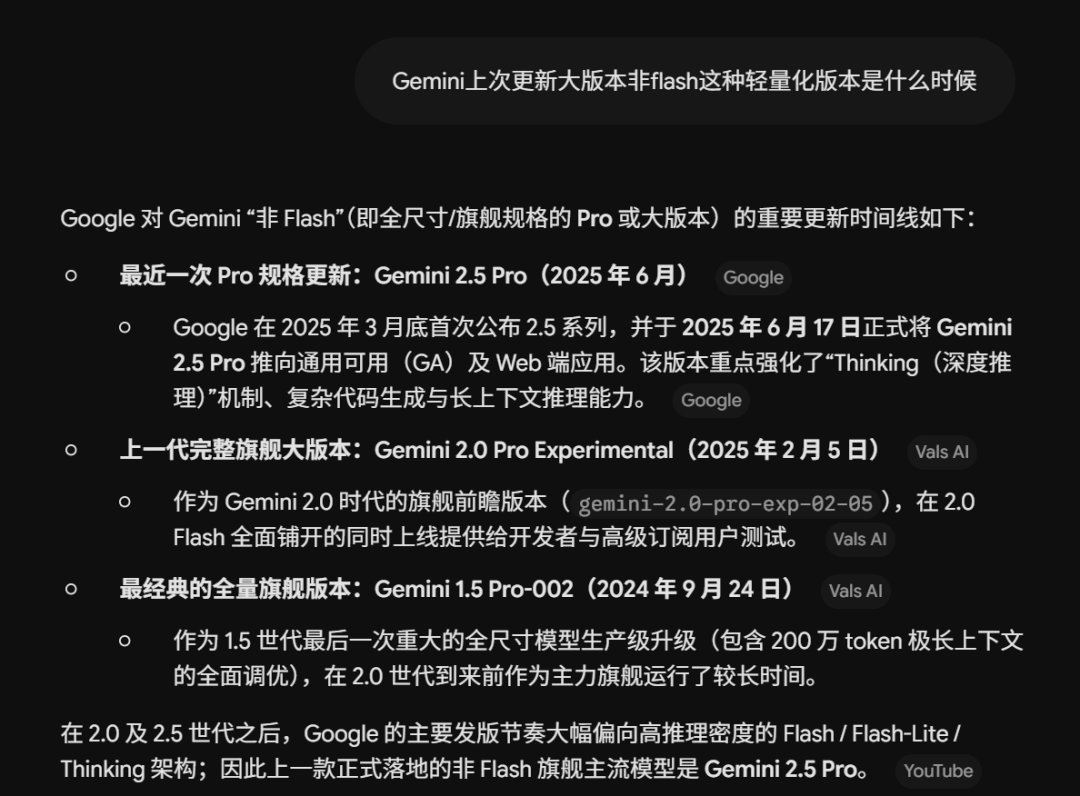
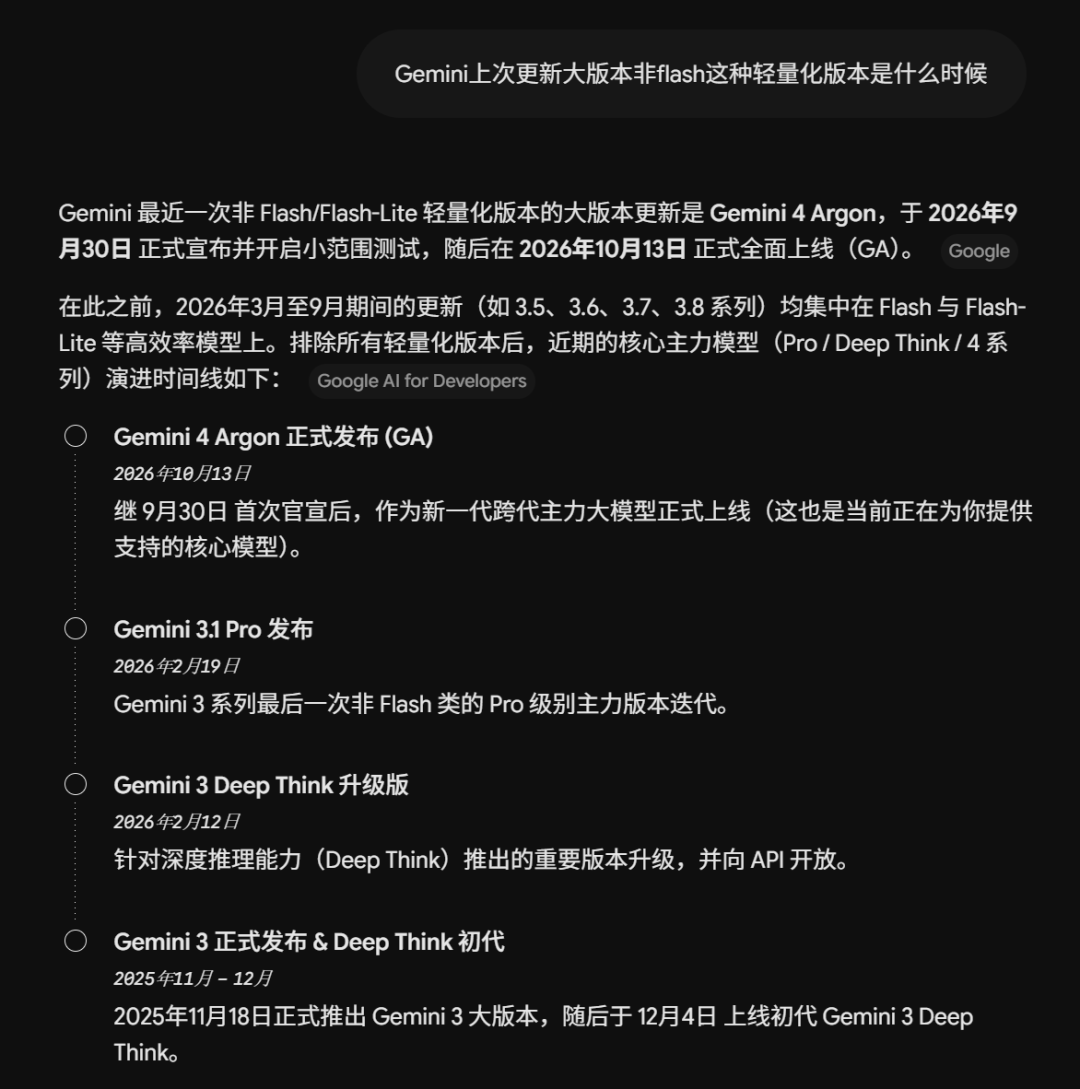
相信看到这里,很多差友要说,响应独一档、文案最通人性、幻觉率还低,看起来 Argon 这波好像真没啥短板了?

吹归吹,咱还得泼盆冷水,从我们和网友们首日体验后的评价来看,显然 Gemini4 Argon 还不是最强的代码工具模型。
早在月初,外媒就爆出过猛料,谷歌内部员工对 Gemini4 的实战表现犯嘀咕,自家人都吐槽,虽然它在通用基准测试里分数亮眼,但实际真用来敲代码还是不够好用。
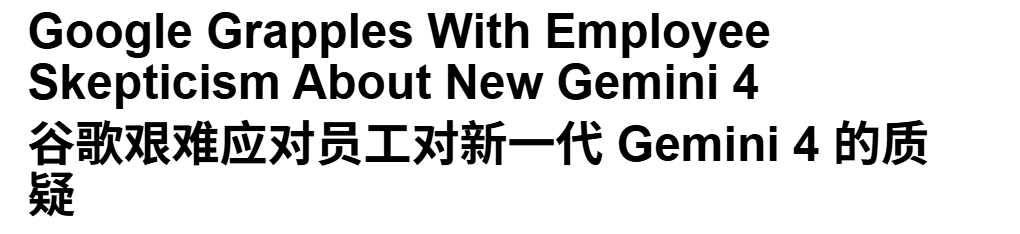
特别是在前端 UI 视觉交互以及 3D 游戏控制逻辑细节上表现相当拉胯。
虽然前面跑个单页 HTML 小动画看着挺唬人,但不少网友在吐槽,一旦进了复杂的真实项目,Gemini 4 Argon 显然有点顶不牢了。
而且就在谷歌官方公布完整跑分表里,这个毛病已经暴露了。
咱们仔细看下 Gemini 4 得分不太高的几个测试,一个是 FrontierSWE,主要测的是模型处理超级复杂的任务的能力,一个是 Terminal-Bench,测试的是模型在终端里具体干活的能力。
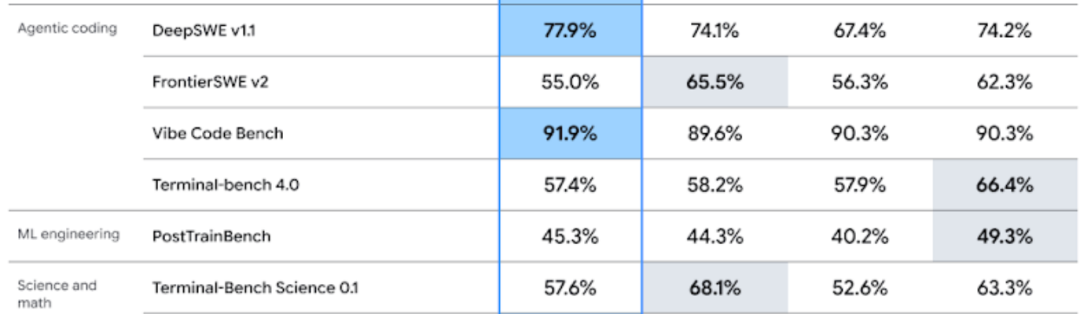

这就意味着如果你要干的活,是看几千万行老代码做架构规划、或者审几百页的法务合同的话,Argon 见谁秒谁;但真让它进命令行终端真刀真枪敲代码,从跑分就能看出来,在四大旗舰里垫底,连次旗舰 Claude Sonnet 5.5 都能甩它一脸。
至于目前看起来的性价比高,也值得商榷。
Argon 在推广期 ( 截止到 11 月 30 号 ) 内的 API 定价是,每百万输入 Token 仅 2 美元、输出 10 美元 ( 缓存输入更是打 0.5 折仅收 0.10 美元 ),但在推广期过后就翻倍恢复到 $4 / $20 的标准价,和 Claude Opus 5.5 相当。
但 Artificial Analysis 在评测后表示,Argon 表面上不和网友们逼逼赖赖,后台推理全是碎碎念。
根据他们的测试结果,各家前沿模型消耗的 Token 中位数大约是 8200 万,而 Argon ( High 档位 ) 足足烧掉了 1.1 亿 Token,思维链膨胀度比行业基准高出了 34%。。。
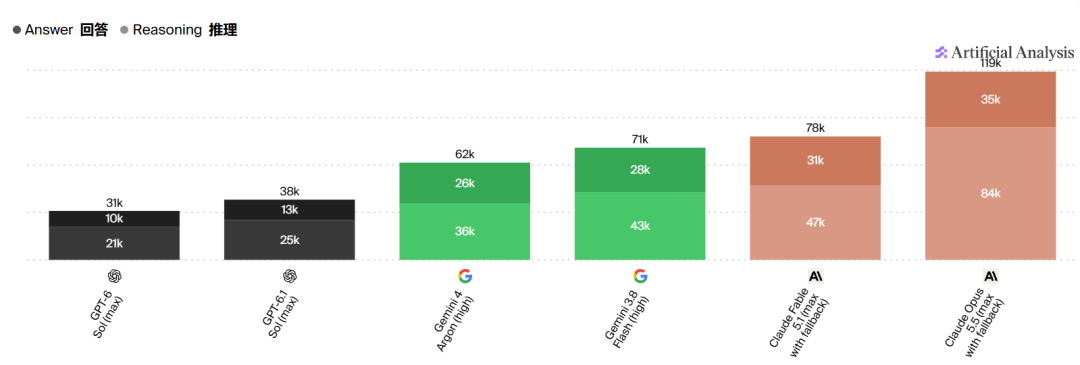
如果把这部分消耗算进去,Gemini 4 Argon 似乎就没那么香了。
当然了,如果是网页端或者 APP 的会员用户,如今可以直接凭 Pro 账号小蹬几手 Argon,依旧性价比拉满。
总的来说,经过大半年的漫长等待,凭借着 Gemini 4 Argon 的推出,谷歌在代码能力方面,总算是死死咬住了第一梯队了,文本能力依然稳中有升。

但这绝对不是谷歌就能够大赢特赢的时候,要知道,一旦用户的刻板印象形成,哪怕你是谷歌,也很难能够扭转回来。
可千万不能再出现,类似过去这 8 个月的 “ 冷静期 ” 了。
不过,外界有消息称,谷歌年底还要搞事,几天前曝光的谷歌内部文件显示,谷歌其实按照字母和元素顺序同步测试了三个迭代检查点:Argon ( 氩 )、Barium ( 钡 ) 与 Carbon ( 碳 )。
这次发布的 Argon,实际内部标注是 Barium,所以后续可能还有高手 Gemini4 Carbon,内部人员表示这代码能力 “ 感觉能和 Claude Opus 5.5 碰一碰 ”。
至于这波到底是谷歌的又一张大饼,还是真正的绝地反击,咱们且等着。
希望这回,别又从一个 Coming Soon,等到下一个 Coming Soon。
本文来自转载差评 ,观点仅代表作者本人,发现AI平台仅提供信息存储空间服务。
如若转载,请联系原作者;如有侵权,请联系编辑删除。
 微信扫一扫